Araç özelliklerinden CO₂ emisyonu tahmini ve karbon ayak izi sınıflandırması
Kanada'da satılan 7.385 aracın motor hacmi, silindir sayısı, şanzıman, yakıt türü, araç sınıfı ve yakıt tüketimi bilgileriyle km başına CO₂ emisyonunu tahmin ediyorum. Çalışmanın merkezindeki soru: yakıt tüketimini modele vermek başarıyı ne kadar yanıltıcı biçimde yükseltiyor?
Proje durumu
Projenin hangi aşamada olduğunu tek bakışta gösterir. Liste, sayfanın sonundaki yol haritasından otomatik okunur.
Şu anki aşama: – · Ara rapor teslime hazır (PDF + notebook)
Bu proje nasıl geliştirildi?
Teknik bilgisi olmayan biri de anlasın diye adım adım ve sade bir dille. Her adımın altında günlük hayattan bir benzetme var.
Bir soru seçtim
"Bir arabanın teknik özelliklerine bakarak ne kadar CO₂ saldığını tahmin edebilir miyim?" Ölçülebilir, gerçek veriyle cevaplanabilir bir soru.
Benzetme: Yemek yapmadan önce ne pişireceğine karar vermek.proje önerisi3 araştırma sorusuVeriyi buldum
Kaggle'dan Kanada hükümetinin 7.385 araçlık resmî ölçümlerini indirdim. Dosyayı hiç değiştirmeden sakladım ki herkes aynı sonuca ulaşabilsin.
Benzetme: Malzemeyi güvenilir bir marketten almak ve fişini saklamak.KaggleCSVSHA-256 kontrolüVeriyi temizledim
Aynı araç birden çok kez yazılmıştı (1.103 tekrar). Bunları sildim; yoksa model aynı soruyu hem çalışırken hem sınavda görür, kopya çekmiş olurdu. Şanzıman kodunu (ör. AS6) "tip" ve "vites sayısı" diye ikiye böldüm.
Benzetme: Sebzeleri yıkayıp çürüklerini ayıklamak.pandassrc/veri.pyVeriyi tanıdım, bir tuzak fark ettim
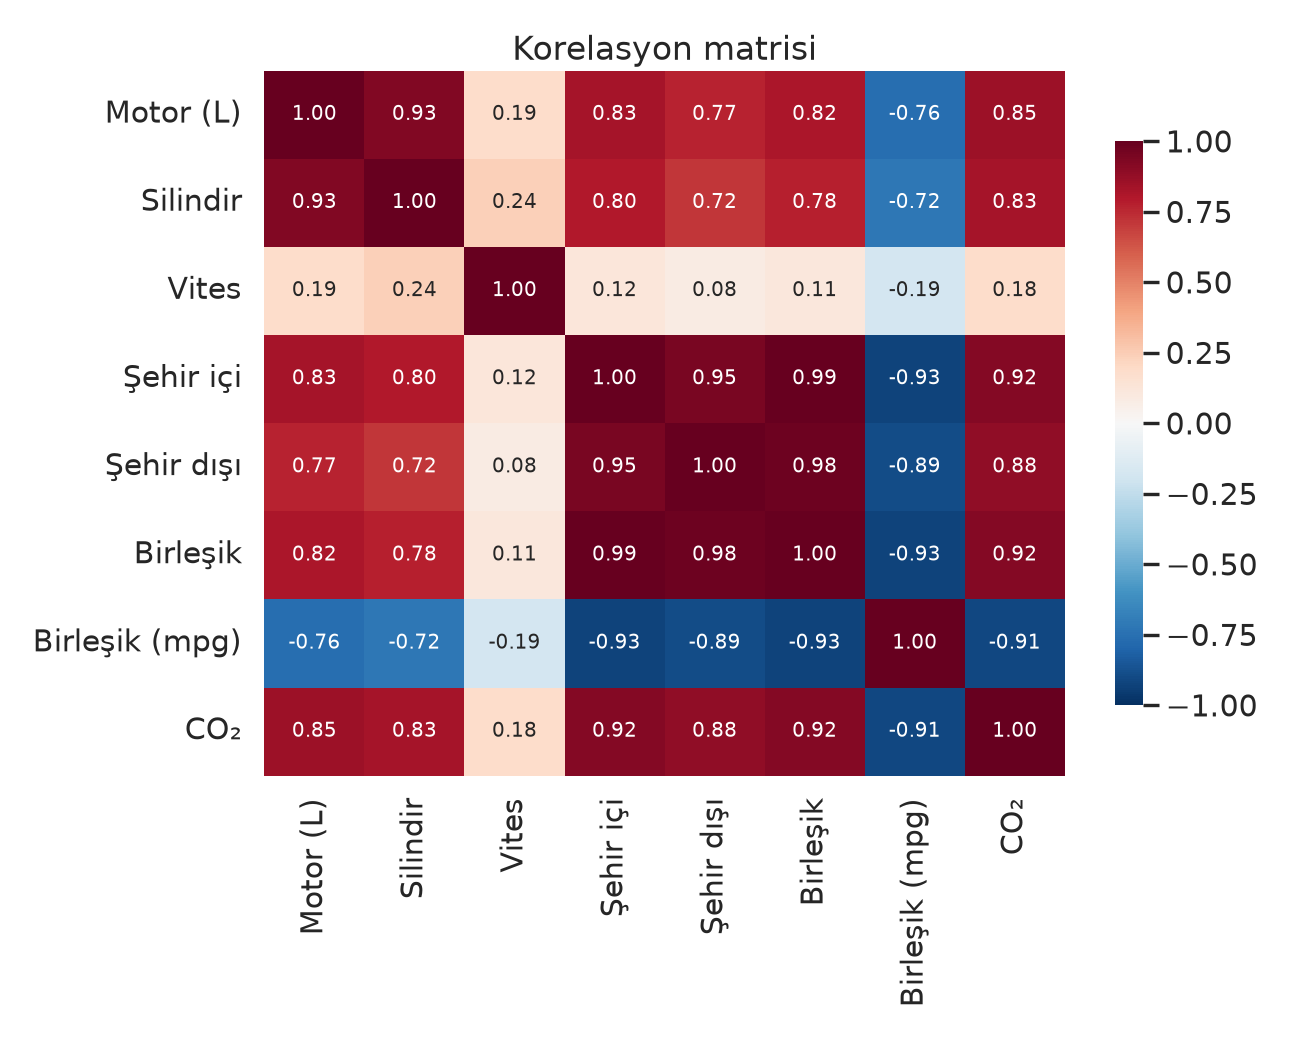
Grafikler çizerken yakıt tüketimi ile CO₂'nin neredeyse kusursuz bir doğru oluşturduğunu gördüm. Çünkü CO₂ zaten yanan yakıttan hesaplanıyor. Tüketimi modele verirsem model tahmin etmez, sadece çarpma yapar. Buna veri sızıntısı denir.
Benzetme: Sınavda cevap anahtarı masada duruyorsa alınan 100 puan bilgiyi göstermez.matplotlibseabornsrc/01_eda.pyİki senaryo kurdum
A: tüketim dahil (sızıntılı) ve B: yalnız araç özellikleri (dürüst). Aynı modelleri ikisinde de çalıştırıp farkı ölçtüm. Böylece sızıntının başarıyı ne kadar şişirdiği sayıyla görünür oldu.
Benzetme: Aynı öğrenciye bir kez kopya kağıdıyla, bir kez kağıtsız sınav yaptırmak.A / B karşılaştırması7 farklı modeli eğittim ve ayarladım
Doğrusal regresyondan XGBoost'a kadar 7 model denedim. Her modelin ayar düğmelerini (hiperparametre) bilgisayara tek tek denettim ve en iyisini seçtirdim.
Benzetme: Fırının sıcaklığını ve süresini deneye deneye en lezzetli sonucu bulmak.scikit-learnXGBoostGridSearchCVsrc/02_regresyon.pyAdil biçimde ölçtüm
Veriyi 5 parçaya böldüm; model her seferinde 4 parçayla çalışıp 1 parçada sınav oldu (çapraz doğrulama). Ayrıca %20'lik bir test kümesini en sona kadar hiç göstermedim.
Benzetme: Tek bir sınava değil, 5 farklı deneme sınavının ortalamasına bakmak.5 katlı CVMAE · RMSE · R²PipelineAraçları "düşük / orta / yüksek" diye sınıflandırdım
Sayı tahmininin yanında araçları üç karbon sınıfına ayırdım. Sınıflar eşit dağılmadığı için doğruluk yerine makro F1 puanına baktım.
Benzetme: Sınıfın %60'ı "orta" ise herkese "orta" diyen öğretmen %60 haklı çıkar ama hiçbir şey bilmiyordur.Lojistik regresyonRandom Forestmakro F1Rapor ve bu siteyi otomatik ürettim
Tüm sayılar ve grafikler kodla üretiliyor; elle kopyalanmış bir değer yok. Kod tekrar çalışınca rapor (PDF), notebook ve bu sayfa kendini günceller.
Benzetme: Tarifi yazıya dökmek: aynı tarifi kim uygularsa aynı yemeği alır.JupyterChart.jssrc/site_verisi.pypython-docxSırada ne var?
Az örnekli sınıflar için SMOTE, modelin kararlarını açıklamak için SHAP ve benzinli araç yerine hibrit alınırsa yılda ne kadar CO₂ tasarruf edileceği hesabı.
Benzetme: Yemeği pişirdik; şimdi tadına bakıp neden lezzetli olduğunu açıklayacağız.imbalanced-learnSHAP
Araştırma soruları
Proje önerisindeki üç problem, ölçülebilir sorulara çevrildi. Her kartın altında şu ana kadarki cevap var.
Yakıt tüketimi başarıyı ne kadar şişiriyor?
Aynı modeller tüketimle ve tüketimsiz eğitilip fark ölçülüyor.
Ayarlanmış 7 model içinde hangisi en iyi?
GridSearchCV ile ayar, 5 katlı çapraz doğrulama ile karşılaştırma.
SMOTE azınlık sınıflarını iyileştirir mi?
Düşük / Orta / Yüksek sınıflarda SMOTE'lu ve SMOTE'suz kıyas.
Veri seti ve hazırlık
Kaynak: Kaggle, CO2 Emission by Vehicles. Kanada hükümetinin yakıt tüketimi derecelendirme verisinden derlenmiş 7 yıllık kayıt; dosya Kaggle'dan indirildiği haliyle kullanıldı.
CO₂ emisyonu dağılımı
g/km, 10'luk aralıklarKesikli çizgiler sınıf eşikleri (200 ve 300 g/km). Ortalama 251,2, en düşük 96, en yüksek 522.
Temizlik adımları
Her adımda kalan satır sayısı.
Neden tekrarlar silindi? Aynı araç hem eğitimde hem testte bulunursa model onu ezberler ve test skoru şişer. Verinin %15'i tekrar olduğu için bu gizli bir sızıntı kaynağı.
Özellik mühendisliği: şanzıman kodu (ör. AS6) tip (A, AM, AS, AV, M) ve
vites sayısı olarak ikiye ayrıldı; CVT için ayrı bayrak eklendi.
Değişkenler
| Sütun | Açıklama | Tür |
|---|---|---|
| Engine Size (L) | Motor hacmi | sayısal |
| Cylinders | Silindir sayısı | sayısal |
| Transmission | Şanzıman tipi + vites sayısı | kategorik |
| Fuel Type | X normal, Z premium benzin, D dizel, E etanol | kategorik |
| Vehicle Class | 16 araç sınıfı (kompakt, SUV, pikap…) | kategorik |
| Make | 42 marka | kategorik |
| Fuel Consumption ×4 | Şehir içi, şehir dışı, birleşik (L/100 km, mpg) | sızıntı |
| CO₂ Emissions | Hedef: g/km | sayısal |
Araç sınıfına göre CO₂
çeyrekler arası aralık ve medyanVeri sızıntısı: model tahmin etmiyor, hesaplıyor
CO₂, yanan yakıtın kimyasal sonucu. Bu yüzden yakıt türü ve tüketim bilindiğinde emisyon tek bir çarpmayla elde ediliyor. Aşağıdaki grafikte her yakıt türü neredeyse kusursuz bir doğru oluşturuyor.
Birleşik tüketim ve CO₂
yakıt başına en fazla 350 araç; açmak/kapatmak için açıklamaya tıklayınCO₂ / tüketim oranı
| Yakıt | Oran | Std | Araç |
|---|
Std ≈ 0,2. 1 L benzin ≈ 2,3 kg, 1 L dizel ≈ 2,7 kg CO₂ üretir; bulunan oranlar bununla uyumlu. Korelasyon "yalnızca" 0,92 görünür, çünkü yakıtlar farklı eğimli doğrularda; korelasyon sızıntıyı küçük gösterebilir.
Deneyin: tüketimden emisyon
Yöntem
Aynı 7 model iki özellik kümesiyle eğitildi: A yakıt tüketimi dahil (sızıntılı) ve B yalnız araç özellikleri (sızıntısız). Test kümesi hiperparametre aramasında hiç kullanılmadı.
Temizlik
Tekrarlar ve tek örnekli doğalgaz aracı silindi
Bölme
%80 eğitim, %20 test, random_state=42
Ön işleme
StandardScaler + OneHotEncoder, Pipeline içinde
Ayar
GridSearchCV, 5 katlı CV, ölçüt RMSE
Değerlendirme
CV ortalaması ± std ve test kümesi: MAE, RMSE, R²
Neden Pipeline?
Ölçekleme ortalaması ve standart sapması tüm veriden hesaplansaydı test katının bilgisi eğitime karışırdı. Ön işlemi Pipeline'ın içine koyunca her CV katında istatistikler yalnız o katın eğitim verisinden hesaplanıyor. k-NN mesafeye, Ridge/Lasso ceza terimine dayandığı için ölçekleme bu modellerde şart.
Seçilen hiperparametreler
Regresyon sonuçları
5 katlı çapraz doğrulama ortalamaları. Metriği değiştirerek iki senaryo arasındaki farkı inceleyebilirsiniz.
R² karşılaştırması
Tüm sonuçlar
Birim g/km. Yeşil: senaryodaki en iyi değer.
| Model | Senaryo | CV MAE | CV RMSE | CV R² | Test RMSE | Test R² |
|---|
Bulgular
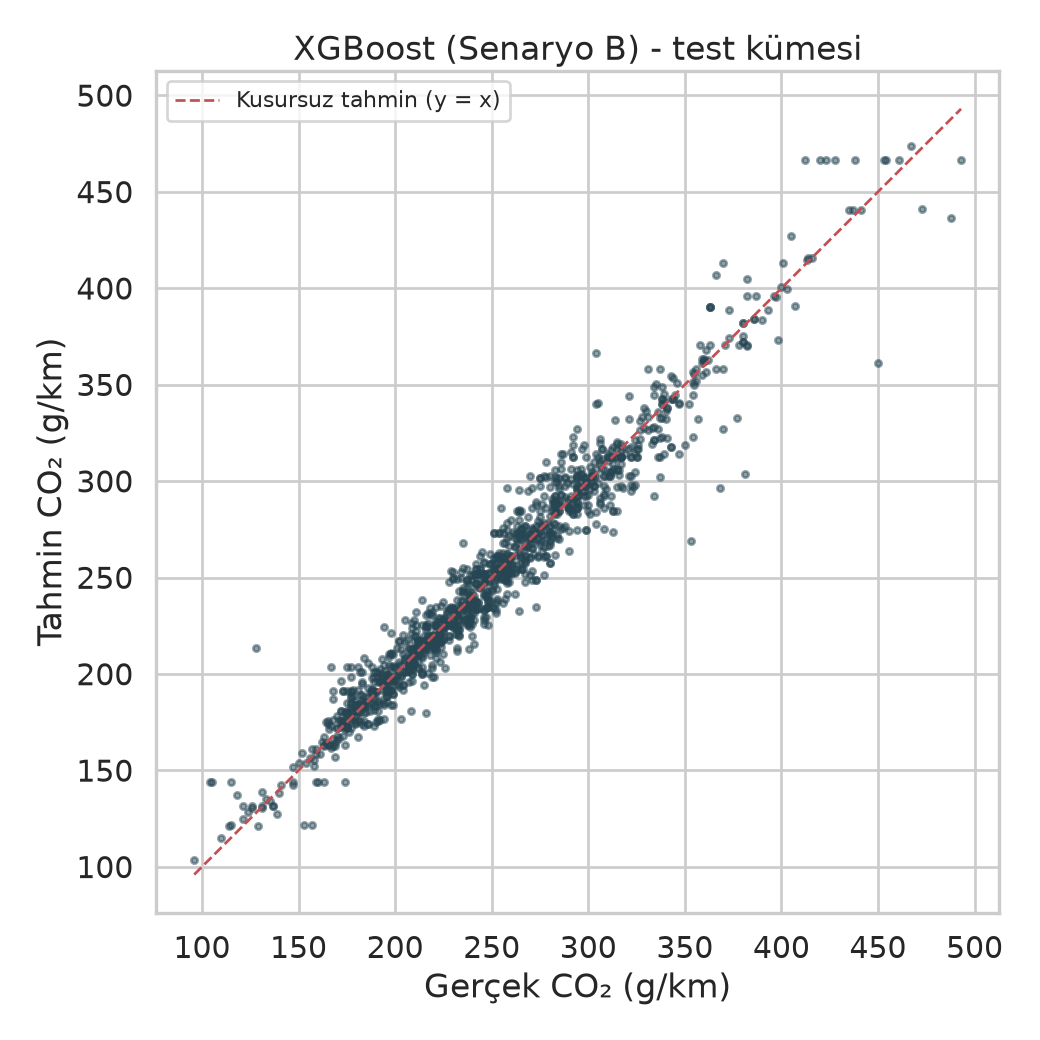
- Sızıntı başarıyı şişiriyor. XGBoost'un RMSE'si 2,6'dan 13,3 g/km'ye çıkıyor. A senaryosundaki 0,998'lik R² iyi bir modelin değil, sızıntının göstergesi.
- En çok doğrusal modeller düşüyor. R² 0,993 → 0,873. Tüketim yokken ilişki doğrusal değil; ağaçlar ve k-NN etkileşimleri yakalıyor.
- Ridge/Lasso fark yaratmıyor. Seçilen alpha çok küçük; 5.000 satır ve ~70 özellikte aşırı öğrenme yok.
- Model genelleşiyor. CV ve test RMSE'si yakın (13,32 / 13,18), katlar arası std ±0,4.
- Pratik hata ≈ %4. Sızıntısız en iyi model ortalama ~9,5 g/km sapıyor; ortalama emisyon 250 g/km.
Özellik önemi (Random Forest, B)
SHAP öncesi ön bakışSilindirin payı düşük görünüyor, çünkü motor hacmiyle korelasyonu 0,93: ağaç önce motor hacmini seçince silindirin bilgisi tükeniyor. Bu ölçünün bilinen bir zayıflığı; SHAP analizi bu yüzden planlandı.
Karbon ayak izi sınıflandırması
Araçlar Düşük (<200 g/km), Orta (200–300) ve Yüksek (≥300) olarak üç sınıfa ayrıldı. Eşikler fiziksel anlamı olsun diye sabit seçildi; bunun sonucu dengesiz dağılım. Bu bölümde şu an SMOTE uygulanmamış temel modeller var. Özellikler sızıntısız (B) kümeden.
Sınıf dağılımı
Model başarımı
| Model | CV doğr. | CV F1 | Test doğr. | Test F1 |
|---|
Doğruluk yanıltıcı: Her araca "Orta" diyen model bile %60 doğruluk alıyor ama makro F1'i 0,25. Makro F1 her sınıfa eşit ağırlık verdiği için küçük sınıflardaki başarısızlığı gizlemiyor.
Karmaşıklık matrisi (test)
Satır: gerçek sınıf, sütun: tahmin. Hücredeki küçük yazı satır yüzdesi.
Sınıf bazında duyarlılık (recall)
Düşük ile Yüksek hiç karışmıyor; hatalar eşiğe yakın komşu sınıflarda. En zayıf sınıf Yüksek: yüksek emisyonlu araçların ~%21'i "Orta" sanılıyor. SMOTE adımının hedefi bu sınıf.
Yol haritası
Proje önerisindeki adımların durumu. Son iki haftada sınıfta sunulacak.
- Tamamlandı
Veri hazırlığı ve keşifsel analiz
Tekrar temizliği, şanzıman ayrıştırma, sızıntı kanıtı.
- Tamamlandı
7 model × 2 senaryo
GridSearchCV + 5 katlı CV; MAE, RMSE, R².
- Tamamlandı
Temel sınıflandırma
SMOTE'suz lojistik regresyon ve random forest.
- Sıradaki
SMOTE karşılaştırması
imbalanced-learn Pipeline'ı ile yalnız eğitim katlarına uygulanacak; doğruluk, makro F1 ve karmaşıklık matrisi kıyası.
- Planlandı
SHAP ile yorumlama
XGBoost üzerinde TreeExplainer; özet ve tek araç (waterfall) grafikleri.
- Planlandı
Benzinli → hibrit tasarruf
Aynı modelin benzinli ve hibrit sürümleri eşleştirilip yıllık 15.000 km için CO₂ farkı.
- Planlandı
Değerlendirmeyi sıkılaştırma
Nested CV ve marka-model grubuna göre GroupKFold.
Hibrit tasarruf hesabı (yöntem)
Sonuç henüz hesaplanmadı; kullanılacak formül:
tasarruf (kg/yıl) = (CO₂_benzinli − CO₂_hibrit) [g/km]
                    × 15.000 km ÷ 1000
Tekrar üretmek için
pip install -r requirements.txt
python src/01_eda.py
python src/02_regresyon.py
python src/03_siniflandirma_temel.py
python src/site_verisi.py